↓ Ir para o conteúdo principal

Dplyr

Bot com Machine Learning para alertas de investimento

Bot com Machine Learning para alertas de investimento

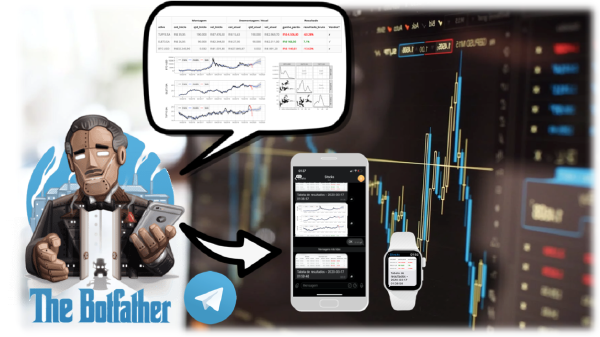
Por que investir? Como esta sua situação financeira? Caso tenha alguma reserva pode ser interessante pensar em investimentos pois a poupança já não é mais garantia de lucro no longo prazo, não acredita? Estamos no final do primeiro trimestre de 2020 e desde 2019 já liam-se notícias como esta abaixo que levam à reflexão sobre reeducação financeira pois alertam sobre a necessidade da busca por novas oportunidades de investimento. Fonte: https://noticias.r7.com/economia/economize/poupanca-em-baixa-exige-busca-por-novos-investimentos-em-2020-25122019 TL;DR O post mostra como montar uma carteira de investimentos combinando renda fixa e renda variável usando a Regra dos 80. Um modelo Prophet, do Facebook, é treinado para prever o comportamento de ações e do Bitcoin a partir de séries históricas. Ao final, um bot no Telegram envia automaticamente uma tabela financeira com ganhos e perdas da carteira em tempo real. Para uma visão histórica da análise de mercado de criptomoedas com R, veja este post de 2017. A evolução desse tipo de análise levou ao desenvolvimento de agentes de IA multiagente para Bitcoin em 2025. Com a finalidade de fomentar um pouco a discussão sobre investimentos, trouxe nesse post algumas sugestões e idéias de como elaborar uma carteira e otimizar as escolhas para equilibrar risco em novos investimentos combinando elementos de estatística, machine learning e programação em R. Ao final do post criaremos um robô no telegram que coletará os dados das cotações adquiridas, aplicará o modelo Prophet do Facebook para forecast e analisará a desmontagem da carteira segundo os critérios estabelecidos e enviará mensagens para nós com uma tabela financeira automatizada via Telegram como mostra na animação: AVISO: Este post não tem como finalidade ser um guia de investimentos (Já existem muitas consultorias especializadas nisso por ai). Todos as decisões tomadas como diversificação da carteira, seleção de ações e critérios para desmontagem da carteira são exemplos e servem para ilustrar algumas possibilidades que um cientista de dados têm na hora de desenvolver ferramentas para auxiliar à tomada de decisão. Diferença de poupar e investir De acordo com um especialista entrevistado pela InfoMoney: “Poupar é guardar dinheiro para usar no futuro, comprar alguma coisa com ele. Investimento é juntar dinheiro, não mexer nele, para que este gere rendimentos e aí sim, usar os lucros mais para frente. É o recomendado para quem quer viver de renda no futuro, por exemplo” (…) InfoMoney - Ago 2015 Ou seja, poupar é acumular agora para utilizar depois, e normalmente envolve mudança de hábitos, pois requer uma redução nos gastos pessoais e familiares, já investir é usar esse dinheiro poupado em aplicações que rendam. Como todo mundo sabe, não existe investimento sem risco e este risco deve ser controlado e utilizado a nosso favor de forma que gere alguma segurança financeira.
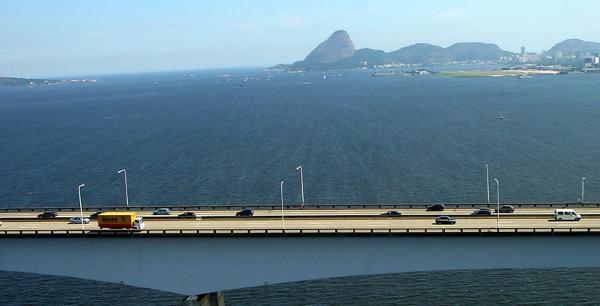
Com que frequência ocorrem acidentes na ponte Rio-Niterói?

Com que frequência ocorrem acidentes na ponte Rio-Niterói?

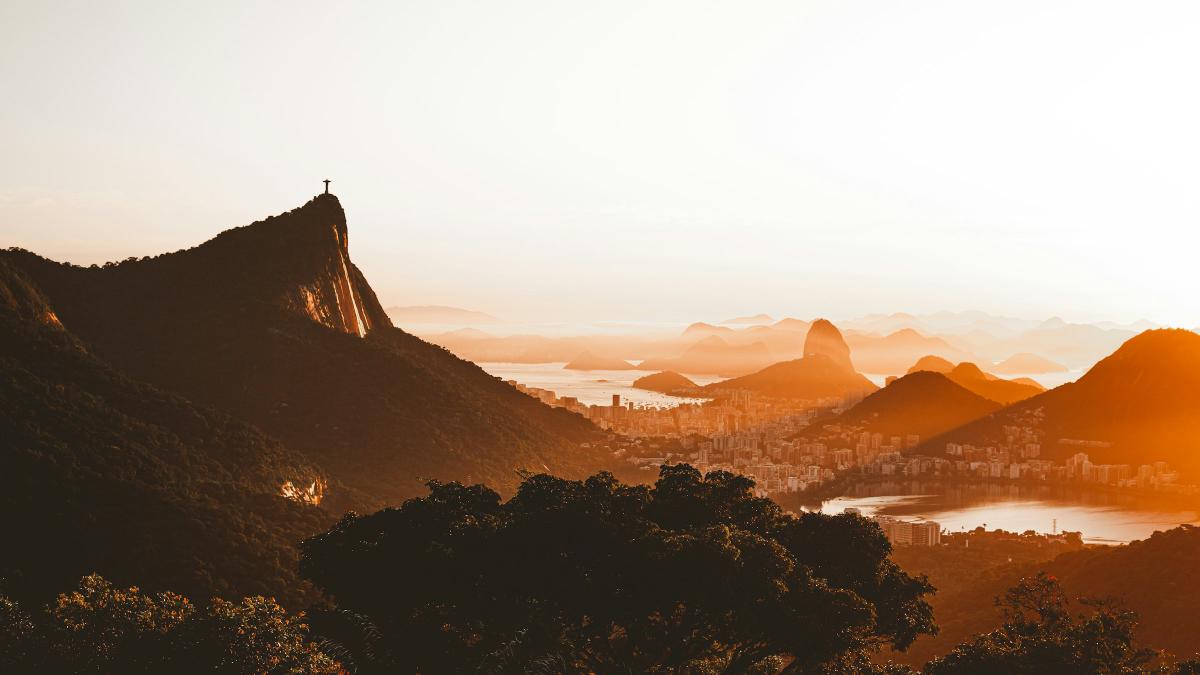
Perguntas Estudar em outra cidade têm suas vantagens e desvantagens, durante toda a graduação atravessei Baía de Guanabara pela Ponte Presidente Costa e Silva, (popularmente conhecida como Ponte Rio–Niterói) assim como todas as pessoas que fazem esse trajeto diariamente e diante de tanta beleza natural com a vista panorâmica da Baía como os espetáculos proporcionados pelo pôr do sol, os pássaros ou a beleza inegável do Pão de Açúcar também é notável a beleza fruto da maior habilidade humana: a criatividade. Temos o cristo, todos aqueles grandes barcos, o Porto do Rio de Janeiro com todas aquelas obras de Engenharia, ou até mesmo a própria Ponte, que por si só já é intrigante. Em contrapartida, dentre as desvantagens está a enorme frequência de engarrafamentos, o custo, o tempo gasto no trajeto e ao refletir sobre a velocidade dos carros na travessia da Ponte e a quantidade de acidentes que ocorrem na me deparei com os seguinte questionamentos: O número de acidentes na ponte é diário? O número de acidentes na ponte têm diminuído? A instalação das câmeras de segurança diminuiu o número de acidentes? Em janeiro de 2018 anunciava-se no jornal: “radares da Ponte Rio-Niterói começam a multar” e como já faz algum tempo que a ponte é monitorada com câmeras de segurança surge a suspeita se o número de acidentes têm diminuído e na vontade de tirar minhas próprias conclusões recorri ao que há de mais abundante por ai: os dados e com o uso de técnicas simples de Estatística iniciei minha “investigação” para obter possíveis respostas para essas perguntas. TL;DR Os dados vêm da PRF (Dados Abertos), filtrados para o trecho BR-101, Km 321-334, que corresponde à Ponte Rio-Niterói. O número de acidentes não se mostrou diário nos últimos 10 anos analisados, e o comportamento dos dados sugere uma diminuição ao longo do tempo. Em 2015, ano da notícia sobre o monitoramento por câmeras, houve uma queda expressiva no número de registros de acidentes. Pacotes utilizados nesta análise: library(grid) # textGrob() library(dplyr) # Manipulacao dos dados library(purrr) # Programacao Funcional library(stringr) # Manipulacao de strings library(magrittr) # Pipes library(leaflet) # Mapa interativo library(leaflet.extras) # + leaflet library(ggplot2) # graficos elegantes library(lubridate) # manipulacao de data library(data.table) # fred() library(forecast) # tslm() library(ggfortify) # autoplot() library(gridExtra) # + ggplot2 library(zoo) # rollmean library(broom) # tidy() augment() glance() library(knitr) # kable() library(kableExtra) # scroll_box library(formattable) # color_bar()
Manipulando dados com dplyr

Manipulando dados com dplyr

O pacote dplyr A análise exploratória dos dados é uma tarefa de bastante relevância para entendermos a natureza dos dados e o tempo de análise é sempre muito precioso. É necessária bastante curiosidade e criatividade para fazer uma boa análise exploratória dos dados pois é difícil receber aqueles dados bonitinhos igual aos nativos do banco de dados do R. A manipulação de dados é uma das etapas que mais consomem tempo em qualquer projeto, como comento no panorama da ciência de dados que escrevi para quem está começando. Aqui o foco é numa das ferramentas centrais para essa tarefa. Existem diversos pacotes para as mais variadas necessidades dos cientistas de dados (ou qualquer pessoa que precise fazer alguma análise ou programação estatística) disponíveis no CRAN e hoje quero registrar aqui algumas das funcionalidades do pacote dplyr que são muito úteis. É um dos pacotes mais poderosos e populares do R, desenvolvido por Hadley Wickham, faz a exploração de dados e permite a manipulação de dados de forma fácil e rápida no R. Segundo sua descrição no CRAN, o dplyr é definido como uma ferramenta rápida e consistente para trabalhar com data.frames como objetos, tanto na memória quanto fora da memória. Vamos conferir então o que de tão especial tem nesse pacote. TL;DR O operador pipe %>% encadeia operações no formato x %>% f(), lido como "pegue x e aplique f". filter(), select(), arrange(), mutate() e summarise() cobrem a maioria das tarefas de manipulação de dados. inner_join(), left_join() e afins combinam bases diferentes por uma chave comum. Operador pipe: %>% O operador %>% é uma opção incrivelmente útil para a manipulação dos dados, funcionando com uma lógica diferente da nativa do R, que executa funções no formato f(x), o pipe permite que façamos operações no formato x %>% f() que basicamente funciona da maneira como raciocinamos: “Pega esse objeto e executa isso, depois isso, depois isso…” Realiza múltiplas ações sem guardar os passos intermediários. Vamos começar carregando o pacote: # Carregando o pacote dplyr suppressMessages(library(dplyr)) Selecionando n linhas aleatorias: função sample_n() # Selecionando 5 linhas aleatoriamente df%>% sample_n(5) Removendo linhas duplicadas: função distinct() Baseado em todas as variáveis # excluindo linhas iguais df%>% distinct() Baseado em uma variável # excluindo linhas que possuem Datas iguais df%>% distinct(Datas) Baseado em mais de uma variável # excluindo linhas que possuem ano e consumo iguais df%>% distinct(ano, consumo) Selecionando colunas (variáveis): função select() # Selecionando a variavel ano e todas as variáveis de sucesso até tonalidade na df df%>% select(ano, sucesso:tonalidade) # Selecionando todas as variaveis com exceção de ano e id df%>% select(-c(ano,id)) # Selecionando todas as variaveis cujo nome inicia com e df%>% select(starts_with("a")) Podem ser úteis também ends_with() e contains(). Reordenando as as colunas das variáveis: função select() # reorganiza o data frame, iniciando com a variável Datas e depois as demais df%>% select(Datas,everything()) Renomeando variáveis: função rename() # Renomeando a variável Datas para micro df%>% rename(Dia = Datas) Selecionando um subconjunto de linhas que satisfazem uma ou mais condições: função filter() # Selecionando somente os indivíduos do sexo masculino df%>% filter( sexo == "Masculino") # Selecionando somente os indivíduos do sexo masculino e branco df%>% filter( sexo == "Masculino" & tonalidade == "Branco") # Selecionando somente os indivíduos com consumo de 1 a 3 anos e 4 a 7 anos df%>% filter( consumo %in% c("1 a 3","4 a 7")) # Selecionando indivíduos que ou são homens solteiros ou são mulheres casadas df%>% filter( (estado_civil=="Solteiro" & sexo =="Masculino") | (estado_civil=="Casado" & sexo =="Feminino") ) Ordenando seus data frames: função arrange() # Ordenando os dados pela variável ano de forma crescente df%>% arrange( ano ) # Ordenando os dados pela variável ano e consumo df%>% arrange( ano ,consumo) # Ordenando os dados pela variável ano de forma decrescente df%>% arrange( desc(ano) ) Criando uma nova variável: função mutate() e transmute() # Criando a variável ano ao quadrado df%>% mutate( ano2 = ano**2 ) # Criando a variável Dia e a variável Mes df%>% mutate( Dia = substring(Datas,1,2), Mes = substring(mensalidade,1,1) ) # Se você quiser somente manter as variáveis criadas df18 = transmute(mensalidade = substring(Datas,1,2), Mes = substring(mensalidade,1,1) ) Resumindo variáveis: função summarize() # Calculando a media e a mediana da variável ano df%>% summarise( media.ano = mean(ano), mediana.ano = median(ano)) Resumindo variáveis por grupo: função group_by() e summarize() # Calculando a media da variável ano para as combinações entre sexo, consumo e estado civil e a frequencia de indivíduos em cada combinação df%>% group_by(sexo, consumo, estado_civil)%>% summarise(media.ano = mean(ano),frequencia=n()) # Calculando a media da variável ano para as combinações entre ano legal, consumo e estado civil e a frequencia de indivíduos em cada combinação df%>% group_by(id, consumo, estado_civil)%>% summarise(media.ano = mean(ano),frequencia=n()) Mais exemplos com o operador pipe Portanto, o operador %>% realiza múltiplas ações sem guardar os passos intermediários. Mais alguns exemplos: # Selecionando as variáveis ano e id df %>% select(ano,id) df %>% select(-estado_civil) %>% filter(sexo=="Masculino") %>% group_by(tonalidade,consumo) %>% summarise(maximo=max(ano),media=mean(ano)) Aplicando funções em linhas df%>% mutate(ano2 = ano**2 )%>% rowwise() %>% mutate(Max= max(ano:ano2)) %>% select(ano,ano2,Max)